

Ausgangslage
Generative KI-Systeme verarbeiten Daten anders als klassische Fachanwendungen. Eingaben, Kontextdokumente und Ergebnisse durchlaufen dabei mehrere Komponenten, die in der Regel von Drittanbietern betrieben werden. Für Unternehmen und öffentlich-rechtliche Institutionen mit Vertraulichkeits- und Geheimhaltungspflichten müssen deshalb Datenschutz, Informationssicherheit und Vertraulichkeit bereits bei der Architektur berücksichtigt werden.
Massgebliche Rahmenbedingungen
- Datenschutzgesetz (DSG; SR 235.1), insbesondere Datenschutz durch Technik (Art. 7), Datensicherheit (Art. 8), Auftragsbearbeitung (Art. 9), Bekanntgabe ins Ausland (Art. 16) und Datenschutz-Folgenabschätzung (Art. 22)
- Kantonale Datenschutzgesetze für öffentliche Organe
- Amtsgeheimnis und Berufsgeheimnisse
- Spezialgesetzliche Geheimhaltungs- und Aufbewahrungspflichten
Zentrale Herausforderungen
Datenstandort und ausländischer Zugriff. Viele leistungsfähige Sprachmodelle werden von Anbietern betrieben, die dem US-amerikanischen Rechtsraum unterliegen. Ein Rechenzentrum in der Schweiz schliesst mögliche Zugriffe ausländischer Behörden aufgrund rechtlicher Verpflichtungen des Anbieters nicht automatisch aus. Der Datenstandort allein bietet daher keinen vollständigen Schutz.
Datenflüsse innerhalb der Architektur. Ein RAG-System (Retrieval-Augmented Generation) erzeugt neben den Quelldaten weitere Bestände, etwa Textfragmente, Vektorindizes, Protokolle und Zwischenergebnisse. Diese müssen entsprechend ihrer Schutzwürdigkeit klassifiziert und bei Zugriffskontrolle, Aufbewahrung und Löschung berücksichtigt werden.
Berechtigungsdurchgängigkeit. Das System darf nur Inhalte für eine Antwort verwenden, für die die anfragende Person im Quellsystem über die erforderliche Berechtigung verfügt. Die Berechtigungen aus dem führenden System, etwa einem DMS, sind deshalb auch beim Retrieval zu prüfen.
Zweckbindung und Weiterverwendung. Es ist vertraglich und technisch sicherzustellen, dass Eingaben, Kontextdaten und Ausgaben nicht für eigene Zwecke des Anbieters, insbesondere nicht zum Training allgemeiner Modelle, verwendet werden. Die Speicherung, Protokollierung und Löschung muss klar geregelt sein.
Nachvollziehbarkeit und Rechenschaftspflicht müssen gewährleistet sein. Modellantworten sind probabilistisch und können fehlerhaft sein. Für geschäftsrelevante Vorgänge sind deshalb Quellenbezug, angemessene Protokollierung und, abhängig vom Anwendungsfall, eine menschliche Prüfung vorzusehen.
Agentensysteme. Agenten können selbstständig Werkzeuge aufrufen oder Daten in andere Systeme schreiben. Über Prompt Injection können manipulierte Dokumente ungewollte Aktionen oder Datenabflüsse auslösen. Die Rechte jedes Agenten und seiner Werkzeuge sind deshalb auf das notwendige Minimum zu beschränken.
Trennung von RAG, LLM und Processing
Eine robuste Architektur trennt drei Schichten:
- Wissensschicht (RAG): Quelldokumente, Textfragmente und Vektorindizes. Der Wissensbestand bleibt im eigenen Kontrollbereich.
- Modellschicht (LLM): Das Sprachmodell erzeugt Antworten aus dem übergebenen Kontext und erhält nur die für die jeweilige Anfrage erforderlichen Daten.
- Verarbeitungsschicht (Processing): Orchestrierung, Aufbereitung, Embedding, Berechtigungsprüfung, Pseudonymisierung und Protokollierung.
Durch die Trennung sind unterschiedliche Schutzzonen und Verarbeitungswege möglich. Die Wissens- und Verarbeitungsschicht können in der eigenen Infrastruktur verbleiben, während das Modell je nach Datenklasse intern oder extern betrieben wird. Ein externer Modellanbieter erhält somit nicht den vollständigen Wissensbestand, sondern nur die für die jeweilige Anfrage freigegebenen Kontextdaten.
Ausgangspunkt sollte deshalb nicht die Wahl des KI-Modells, sondern die Klassifizierung der Informationen sein. Daraus werden zulässige Verarbeitungswege, Modelltypen, Speicherorte und Berechtigungen abgeleitet.
Die Schnittstellen zwischen den Schichten sollen verschlüsselt und authentisiert sein. Da auch das Embedding-Modell die Inhalte verarbeitet, gehört es in die geschützte Verarbeitungsschicht. Vektorindizes sollten nicht ohne Weiteres als anonym betrachtet werden, wenn Rückschlüsse auf Ursprungstexte oder Personen möglich sind.
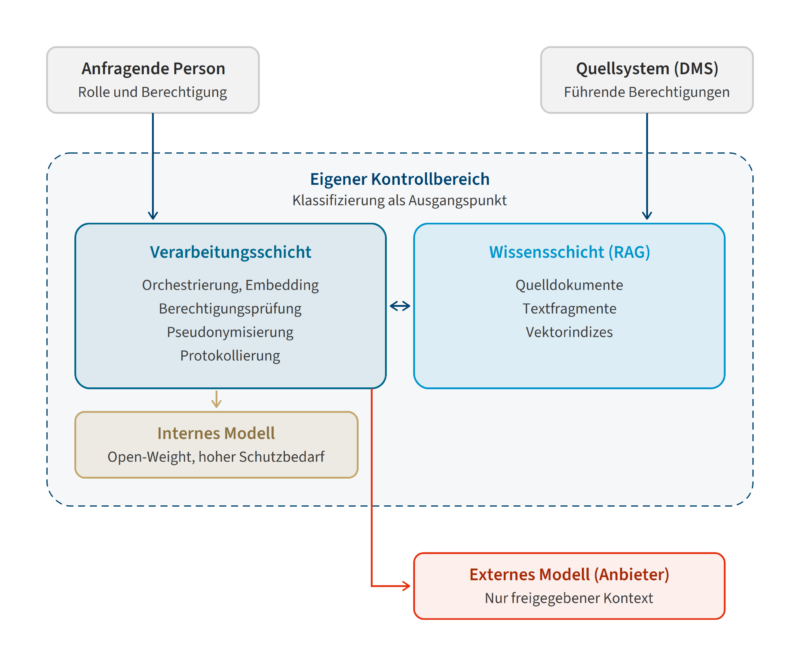
Die Verarbeitungsschicht steuert alle Datenflüsse. Sie prüft die Berechtigungen aus dem Quellsystem beim Retrieval und entscheidet anhand der Datenklasse, ob die Anfrage an das interne Modell oder an das externe Modell geht. Das externe Modell liegt ausserhalb des eigenen Kontrollbereichs und erhält nur den für die jeweilige Anfrage freigegebenen, bei Bedarf pseudonymisierten Kontext, nicht den vollständigen Wissensbestand.
Architekturansätze
- Klassifizierung der Daten und Definition zulässiger Verarbeitungswege und Modelle
- Trennung von Wissens-, Verarbeitungs- und Modellschicht
- Verbleib von Datenbestand, Embedding und Berechtigungsprüfung in eigener Infrastruktur
- Betrieb eigener oder selbst kontrollierter Open-Weight-Modelle für besonders schützenswerte Daten
- Pseudonymisierung oder Filterung vor der Übergabe an externe Dienste, soweit zweckmässig
- Durchsetzung der Quellberechtigungen im Retrieval
- Integration der KI-Bestände in Records Management, Aufbewahrung und Löschung
- Prüfung der Pflicht zur Datenschutz-Folgenabschätzung und Durchführung bei hohem Risiko
Beurteilung
Datenschutzkonformität und Vertraulichkeit wird nicht durch die Wahl eines einzelnen Produkts erreicht, sondern durch die Gestaltung der gesamten Datenkette. Dabei ist die kontrollierte Zuordnung von Datenklasse, Verarbeitungsweg und Modell entscheidend.
Eine Architektur mit getrennten Schichten verbindet die Leistungsfähigkeit externer Modelle mit der notwendigen Kontrolle über vertrauliche und geheimhaltungsbedürftige Daten. Voraussetzungen sind eine belastbare Informationsklassifizierung und ein funktionierendes Berechtigungsmodell in den Quellsystemen.
M.Rumpf

0 Kommentare